L'histoire de l'IA couvre près de huit décennies de recherches, d'espoirs, d'échecs retentissants et de percées qui ont redéfini ce que les machines sont capables d'accomplir. Des premières réflexions théoriques d'Alan Turing dans les années 1940 aux modèles génératifs déployés à l'échelle mondiale dans les années 2020, chaque période a apporté ses propres paradigmes, ses limites et ses ruptures. Comprendre cette trajectoire n'est pas un exercice académique : c'est le moyen le plus direct de saisir pourquoi les systèmes actuels fonctionnent comme ils le font, quelles contraintes persistent et quelles questions restent ouvertes. Voici les grandes étapes de cette histoire, des fondations théoriques aux enjeux réglementaires qui structurent aujourd'hui le déploiement de l'intelligence artificielle.
Aux origines : les fondations théoriques de l'intelligence des machines
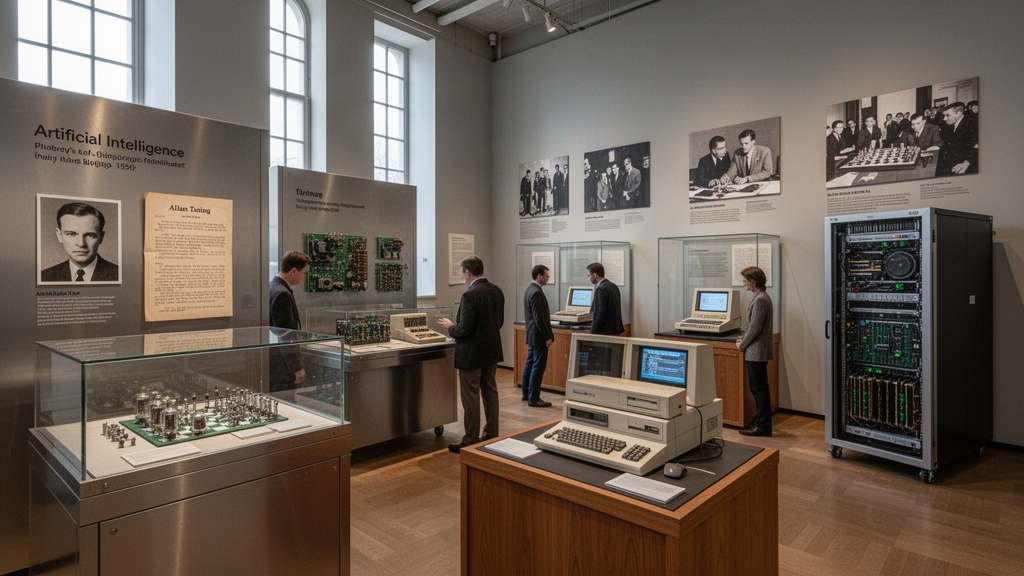
Tout commence avant même que le terme « intelligence artificielle » existe. En 1950, le mathématicien britannique Alan Turing publie l'article Computing Machinery and Intelligence dans la revue Mind. Il y pose une question restée célèbre : « Les machines peuvent-elles penser ? » Pour y répondre, il propose ce qui sera appelé le test de Turing, une expérience imaginaire dans laquelle un observateur humain doit déterminer, à travers un échange écrit, s'il dialogue avec un humain ou une machine. Ce cadre conceptuel oriente des décennies de recherche sur la mesure de l'intelligence artificielle.
Six ans plus tard, en 1956, le Dartmouth College accueille une conférence d'été organisée par John McCarthy, Marvin Minsky, Nathaniel Rochester et Claude Shannon. C'est là que le terme « artificial intelligence » est officiellement proposé dans la littérature académique. La conférence réunit une dizaine de chercheurs convaincus qu'il est possible de simuler chaque aspect de l'intelligence humaine sur une machine. L'ambition est totale, les délais envisagés, très courts. La réalité se révélera bien plus complexe.
Les premières années qui suivent sont marquées par une IA symbolique dominante : des programmes qui manipulent des symboles selon des règles logiques explicites. Le Logic Theorist, développé par Allen Newell et Herbert Simon, démontre dès 1956 que des machines peuvent prouver des théorèmes mathématiques. En 1957, Frank Rosenblatt crée le perceptron, un modèle d'apprentissage inspiré du neurone biologique. Ce premier réseau neuronal artificiel suscite un enthousiasme immédiat, avant que ses limites ne soient exposées publiquement par Minsky et Papert en 1969.
L'histoire de l'IA entre systèmes experts et périodes de désillusion
Les années 1960 et 1970 voient se développer les systèmes experts, programmes capables de raisonner dans un domaine précis à partir de bases de connaissances encodées par des spécialistes humains. MYCIN, développé à l'Université Stanford au milieu des années 1970, diagnostique des infections bactériennes avec une précision comparable à celle de médecins expérimentés. Ces systèmes séduisent les industriels et les gouvernements, qui investissent massivement.
À lire aussi : Les défis de la régulation du contenu en ligne : entre liberté d'expression et protection des utilisateurs
La désillusion arrive en deux vagues distinctes, connues sous le nom d'hivers de l'IA. Le premier s'installe dans les années 1970, après que le rapport Lighthill au Royaume-Uni (1973) conclut que les promesses de l'IA ne se matérialisent pas. Les financements se tarissent. Le second hiver survient à la fin des années 1980 : les systèmes experts révèlent leurs fragilités structurelles, notamment leur incapacité à gérer des situations imprévues ou à s'adapter sans intervention humaine manuelle. Les bases de connaissances deviennent trop coûteuses à maintenir.
Ces deux périodes de ralentissement ne signifient pas l'arrêt de la recherche. Des travaux sur les réseaux neuronaux se poursuivent discrètement, portés notamment par Geoffrey Hinton et ses collaborateurs. L'algorithme de rétropropagation du gradient, popularisé en 1986, permet d'entraîner des réseaux à plusieurs couches. Les résultats restent modestes faute de données suffisantes et de puissance de calcul adéquate, mais les bases théoriques s'affinent.
Voici les jalons chronologiques qui ponctuent cette longue traversée :
- 1950 : publication du test de Turing par Alan Turing
- 1956 : conférence de Dartmouth, naissance officielle du champ de l'IA
- 1997 : Deep Blue d'IBM bat le champion du monde d'échecs Garry Kasparov
- 2012 : AlexNet remporte le concours ImageNet et relance l'apprentissage profond
- 2016 : AlphaGo de DeepMind bat le joueur professionnel de go Lee Sedol (4 à 1)
- 2017 : publication de l'architecture Transformer dans « Attention Is All You Need »
- 2022 : lancement public de ChatGPT par OpenAI le 30 novembre
Du machine learning à la révolution de l'apprentissage profond
Le retour en grâce de l'apprentissage automatique s'amorce dans les années 1990. Les machines apprennent désormais à partir de données plutôt que de règles explicites. Les machines à vecteurs de support (SVM) et les méthodes statistiques progressent. En 1997, Deep Blue d'IBM bat Garry Kasparov lors d'un match officiel d'échecs. Ce résultat frappe les esprits, même si Deep Blue fonctionne sur des principes de recherche exhaustive et de puissance brute de calcul, très éloignés de ce qu'on appellera plus tard l'apprentissage profond.
À lire aussi : Backmarket : 7 bonnes raisons de faire vos achats tech ici
Le tournant décisif se produit en 2012. Le réseau AlexNet, développé par l'équipe de Geoffrey Hinton à l'Université de Toronto, remporte le concours ImageNet avec un taux d'erreur spectaculairement inférieur à celui de ses concurrents. AlexNet repose sur un réseau neuronal convolutif entraîné sur des GPU. Cette performance relance massivement l'intérêt pour l'apprentissage profond dans la communauté académique et industrielle.
Trois facteurs convergent pour rendre possible cette percée : la disponibilité de grandes quantités de données annotées, la montée en puissance des unités de traitement graphique (GPU) de NVIDIA, et la mise au point d'architectures neuronales plus profondes et mieux régularisées. Ces conditions réunies propulsent la vision par ordinateur, la reconnaissance vocale et le traitement du langage naturel vers des niveaux de performance inédits.
Des exploits spécialisés aux modèles génératifs
En 2016, AlphaGo de DeepMind bat le joueur professionnel de go Lee Sedol par quatre parties à une. Le go était considéré comme l'un des derniers bastions de la supériorité humaine sur les machines, en raison de la complexité combinatoire du jeu. AlphaGo combine apprentissage profond, apprentissage par renforcement et recherche arborescente Monte-Carlo. Ce résultat marque un saut qualitatif par rapport à Deep Blue : la machine ne cherche plus par force brute, elle apprend à évaluer des positions.
L'année 2017 apporte une rupture architecturale majeure. Des chercheurs de Google publient l'article « Attention Is All You Need », qui introduit l'architecture Transformer. Ce modèle repose sur un mécanisme d'attention permettant de pondérer l'importance de chaque élément d'une séquence par rapport aux autres. Les Transformers se révèlent extraordinairement adaptables : ils deviennent la colonne vertébrale des grands modèles de langage (LLM) comme GPT, BERT, LLaMA ou Gemini.
À lire aussi : AMP et SEO: Avantages et Pièges
Le 30 novembre 2022, OpenAI lance publiquement ChatGPT. En quelques jours, le service atteint un million d'utilisateurs. Pour la première fois, un système d'IA générative conversationnelle est accessible à quiconque dispose d'une connexion internet. La démocratisation est immédiate. Elle s'accompagne d'une course entre Microsoft, Google, Meta et des dizaines d'acteurs plus modestes pour développer ou intégrer des modèles comparables. Les usages prolifèrent : rédaction, code, analyse de données, génération d'images et de vidéos.
Ce que les prochaines années changent pour l'IA
Le cadre réglementaire rattrape la technologie. En 2024, l'AI Act de l'Union européenne entre en vigueur après publication au Journal officiel. Ce règlement adopte une approche graduée selon le niveau de risque des systèmes : certaines applications jugées inacceptables sont interdites, d'autres soumises à des obligations de transparence et d'audit. Les échéances d'application s'échelonnent jusqu'en 2027 selon les catégories concernées. D'autres institutions, dont le NIST aux États-Unis et l'UNESCO, publient leurs propres cadres de gouvernance.
Les questions de fiabilité et de biais algorithmiques structurent une part croissante de la recherche. Les grands modèles de langage produisent des erreurs factuelles avec la même fluidité que des réponses exactes. Leur dépendance aux données d'entraînement les expose à reproduire des préjugés présents dans ces corpus. Des équipes de recherche chez DeepMind, OpenAI et dans les universités travaillent sur l'alignement des modèles avec des valeurs humaines définies.
La consommation énergétique des centres de données alimentant ces modèles soulève des questions concrètes sur la soutenabilité du développement actuel. Entraîner un grand modèle mobilise des ressources considérables en électricité et en eau pour le refroidissement. La souveraineté numérique devient un enjeu géopolitique : plusieurs États investissent dans des modèles nationaux pour réduire leur dépendance aux infrastructures américaines ou chinoises.
Ce que l'histoire des soixante-dix dernières années enseigne, c'est que les cycles d'enthousiasme et de désillusion se répètent, mais que chaque cycle laisse derrière lui des avancées techniques durables. Les hivers de l'IA n'ont pas effacé les progrès sur les réseaux neuronaux. La prochaine étape ne sera probablement pas l'intelligence générale artificielle dans les délais annoncés par les acteurs les plus optimistes, mais des systèmes plus fiables, mieux documentés et soumis à des obligations de transparence croissantes. La maturité d'un domaine se mesure aussi à sa capacité à se réguler.